






Prompts, documents, photos, conversations personnelles… Nous confions chaque jour davantage d’informations aux IA génératives. Mais une fois envoyées, comment circulent-elles, combien de temps peuvent-elles être conservées et à quoi peuvent-elles servir ?
On leur raconte nos journées, nos problèmes, nos projets. On leur confie des documents de travail, des photos et, de plus en plus souvent, l’accès à nos mails ou à notre agenda.
Au fil des échanges, et à force d’accumulation, toutes ces informations finissent par en dire davantage que ce que nous formulons noir sur blanc :
elles peuvent révéler un métier, des habitudes, des centres d’intérêt, des relations, une façon de travailler ou des préoccupations que nous n’avons jamais explicitement nommées, mais qu’un chatbot IA peut malgré tout déduire de nos conversations.
Or, plus ces interactions permettent d’en apprendre sur nous, moins leur devenir relève du détail.
Il ne s’agit donc plus tant de savoir ce qu’il advient du prompt que de comprendre ce que le service fait de tout ce qu’on lui confie. Que reçoit-il réellement ? Que conserve-t-il ?
Que peut-il réutiliser d’une conversation à l'autre ?
Et dans quels cas nos données peuvent-elles servir à améliorer ou entraîner les modèles ?
Du prompt à la réponse, le parcours d’une requête
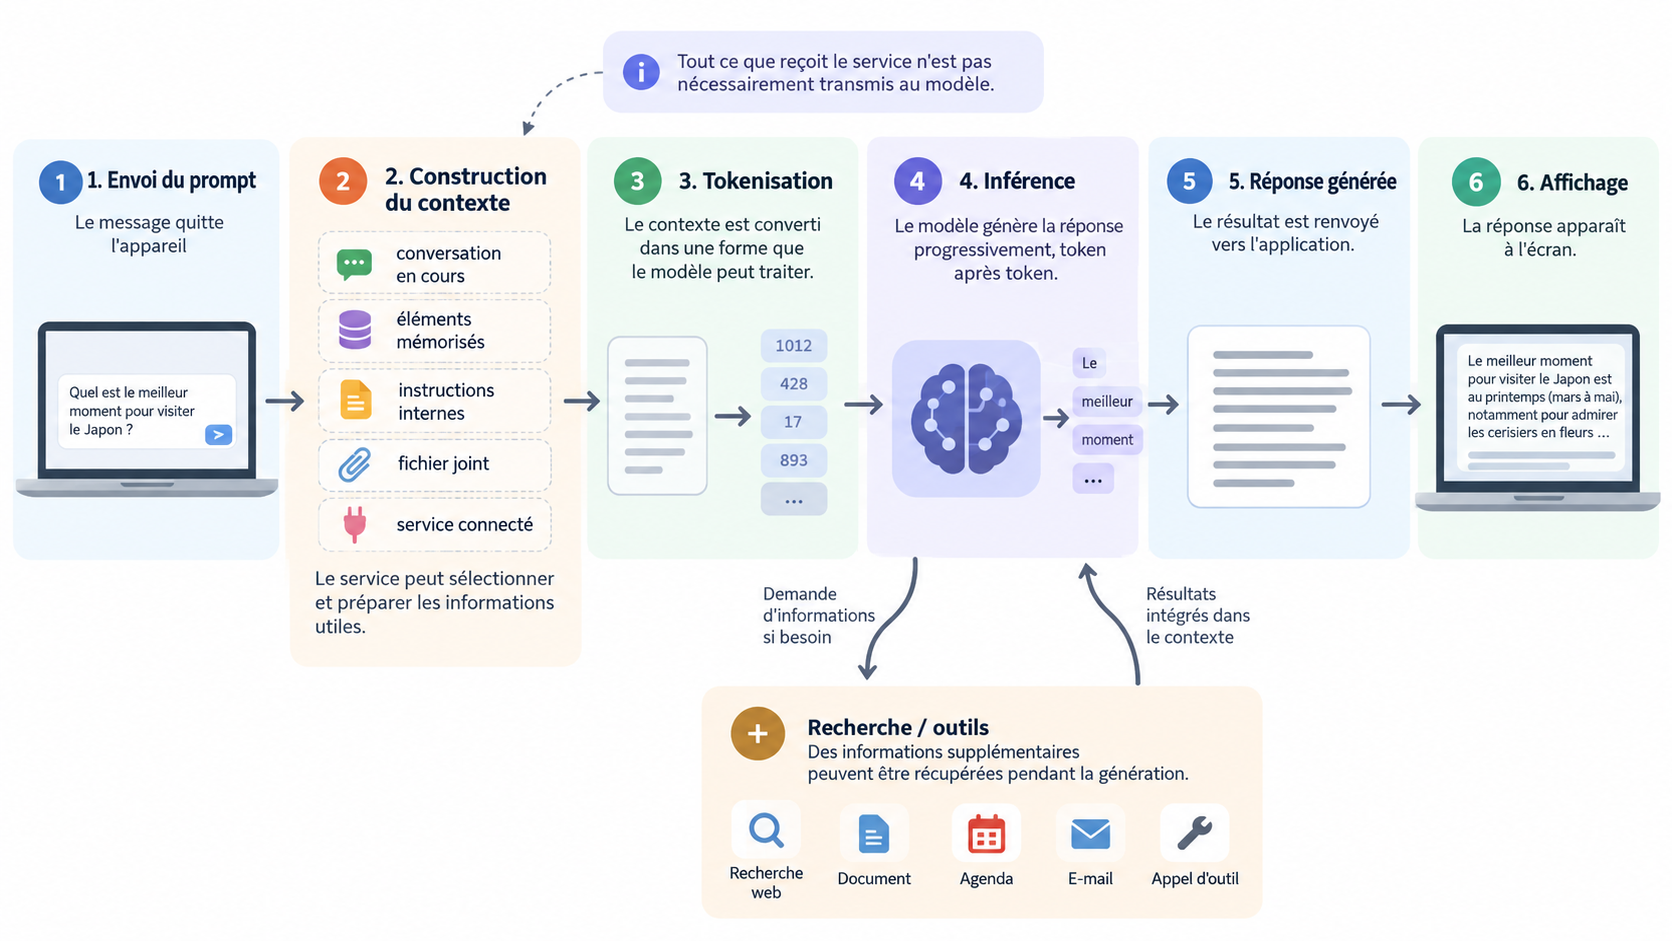
Dès l’instant où l’on clique sur Envoyer, le prompt quitte l’appareil pour rejoindre l’infrastructure distante qui fait fonctionner le service.
À son arrivée, ce message peut être intégré à un contexte plus étendu, composé d’une partie de la conversation en cours, d’éléments mémorisés lors d’échanges précédents, d’instructions internes destinées à orienter la réponse ou encore de données récupérées dans un fichier ou un service connecté.
Si l’on joint un document, par exemple, le service peut en extraire les passages utiles à notre demande ; si on lui donne accès à une messagerie ou à un agenda, il peut aller y chercher les éléments pertinents.
Ce que nous saisissons au clavier ne correspond donc pas toujours à l’intégralité de ce qui sera finalement soumis au modèle, pas plus que le modèle ne reçoit nécessairement tout ce que nous avons confié au service. (sentez votre cerveau commencer à faire de petites bulles)
Une fois ce contexte constitué, il faut encore le convertir dans une forme que le modèle peut traiter.
C’est là tout le rôle des fameux tokens. À partir de cette séquence, le modèle peut commencer à générer sa réponse.
C’est ce qu’on appelle la phase d’inférence : en tenant compte de tout ce qui lui a été fourni, il calcule à chaque étape la probabilité que chacun des tokens de son vocabulaire soit le suivant.
La réponse est donc construite progressivement, et non récupérée toute faite dans une base de données. C’est bien pour cela que l’on parle d’IA générative.
Les éléments mobilisés peuvent d’ailleurs encore évoluer pendant la génération.
Un assistant relié au web, à un moteur de recherche ou à d’autres outils peut aller chercher une information supplémentaire, l’intégrer au contexte déjà constitué, puis poursuivre sa réponse.
Le prompt initial peut ainsi donner naissance à plusieurs échanges techniques invisibles derrière un résultat qui, à l’écran, semble avoir été produit d’un seul bloc.
Une fois la génération terminée, le résultat est renvoyé vers l’application, puis affiché à l’écran.
@Du prompt affiché à l’écran à la réponse générée, une requête passe par plusieurs étapes : constitution du contexte, tokenisation, inférence et, si besoin, appel à des outils ou à des sources externes.
Traiter, historiser, mémoriser, entraîner : vos données peuvent avoir plusieurs vies
Si vous avez bien suivi, vous comprenez donc qu’un prompt tout à fait banal peut faire appel à un paquet de données et d’informations de natures différentes, qui n’interviennent ni au même moment ni pour les mêmes raisons, et dont le devenir varie en conséquence.
Pour répondre, le service exploite d’abord les données dont il a besoin pour accomplir ce qu’on lui demande : c’est le traitement de la requête.
Une fois qu’elles ne sont plus nécessaires à l’échange en cours, leur suppression n’est pas automatique.
Tout ou partie de ces informations peut rester stocké chez le fournisseur, quelques jours ou beaucoup plus longtemps, selon le service, les réglages et la raison de cette conservation.
L’historique en est la manifestation la plus évidente.
On ferme un chat, on revient le lendemain, et la discussion nous attend toujours.
Mais supprimer une conversation de l’interface n’efface pas d’un même geste toutes les données qui lui sont liées.
Là encore, le fournisseur peut en garder certaines sous le coude pendant un temps, pour des raisons techniques, de sécurité, de lutte contre les abus, d’assistance ou pour répondre à des obligations légales.
Historique à ne pas confondre avec la mémoire, qui retient elle aussi son lot de données exploitables.
Elle peut enregistrer des faits que nous avons explicitement confiés au chatbot, mais aussi, selon les services, tirer de nos échanges des préférences, des habitudes ou d’autres éléments de contexte susceptibles de resservir plus tard.
Et puis il y a ce que le fournisseur peut tirer de nos interactions pour améliorer ses systèmes.
Elles peuvent servir à évaluer des réponses, repérer des erreurs, ajuster des composants et, selon les cas, rejoindre les données utilisées pour entraîner ou affiner des modèles.
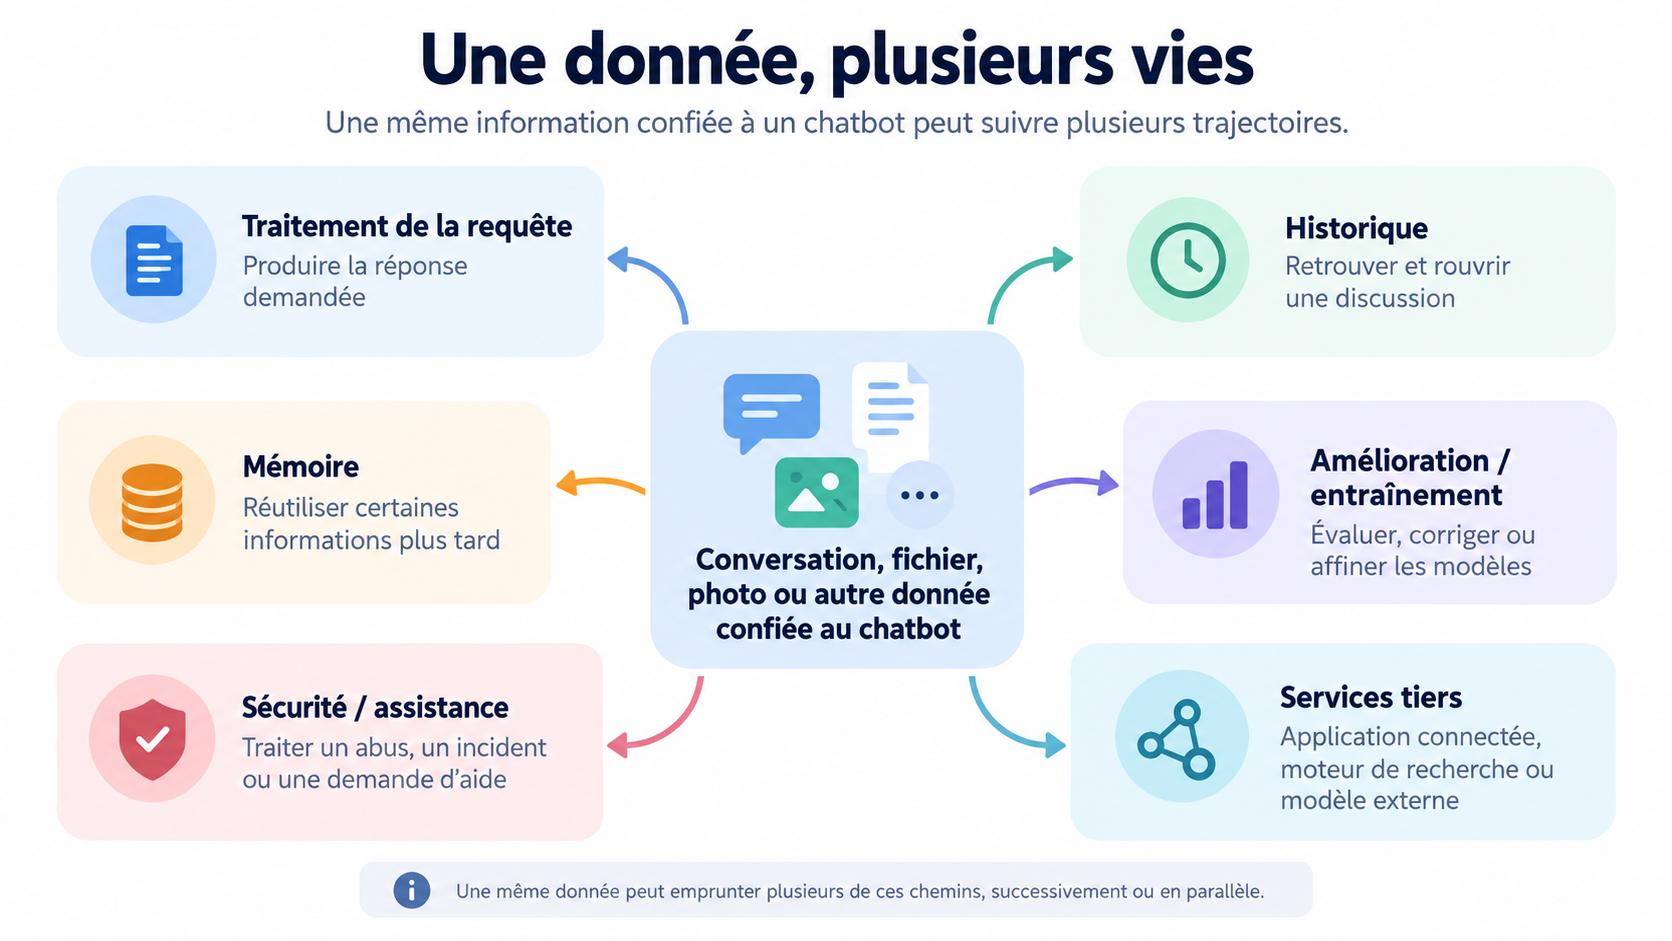
Une donnée n’a donc pas nécessairement une seule destination.
Le fait de l’avoir confiée au service pour obtenir une réponse ne détermine pas, à lui seul, ce qu’elle deviendra ensuite : plusieurs traitements peuvent se succéder ou se superposer, parfois bien après la fin de l’échange qui l’a fait entrer dans le système.
@ Schéma du parcours possible d’une donnée confiée à un chatbot IA, de son traitement immédiat à sa conservation éventuelle dans l’historique ou la mémoire, en passant par l’assistance, les services tiers ou l’amélioration des systèmes.
Derrière le chatbot, plusieurs acteurs peuvent accéder à vos données
Une conversation avec un chatbot n’est pas un tête-à-tête hermétique entre l’internaute et le modèle.
Le gros du traitement est automatisé, mais, comme ailleurs sur le web, des équipes internes ou des prestataires peuvent accéder à une partie des échanges pour examiner un signalement, enquêter sur un abus ou un incident de sécurité, répondre à une demande d’assistance, satisfaire à une obligation légale ou évaluer les services.
Cela ne signifie évidemment pas que des employés passent leurs journées à lire nos conversations.
Chez OpenAI comme chez Google, Microsoft ou Anthropic, ces accès sont encadrés, réservés à des personnes habilitées et limités à des échantillons de contenus ciblés selon les situations.
Nos échanges peuvent aussi sortir du seul périmètre du fournisseur dès lors que l’assistant fait appel à d’autres services, qu’on les ait nous-mêmes branchés au chatbot ou qu’ils interviennent en coulisses pour traiter la requête.
Une application connectée peut ainsi exploiter une partie du contexte tiré de la conversation ou de la mémoire pour exécuter l’action attendue, tandis qu’un service comme Perplexity peut s’appuyer sur des modèles développés par OpenAI, Anthropic ou Google.
Une même requête peut donc passer du chatbot auquel on l’a confiée aux systèmes d’autres entreprises.
Ces échanges sont généralement encadrés par les accords conclus entre les différents fournisseurs, mais les règles de traitement et de rétention des données peuvent varier d’un service à l’autre.
Combien de temps les principaux chatbots gardent-ils vos conversations ?
Il n’existe pas de durée standard, et supprimer un échange de l’interface ne fait pas toujours disparaître immédiatement les données associées.
- ChatGPT : OpenAI efface sous 30 jours les conversations supprimées et les chats temporaires, sauf données déjà désidentifiées ou conservation requise pour des raisons légales ou de sécurité.
- Perplexity : les données peuvent rester tant que le compte existe ; après sa suppression, Perplexity annonce leur effacement sous 30 jours, hors exceptions prévues par sa politique de confidentialité.
- Copilot : Microsoft conserve les 18 derniers mois de l’historique, supprimable manuellement à tout moment.
- Gemini : Google supprime l’activité après 18 mois par défaut, réglable à 3 ou 36 mois ou sans suppression automatique. Lorsque l'enregistrement de l'activité est désactivé, les échanges restent jusqu’à 72 heures ; ceux sélectionnés pour revue humaine peuvent être conservés trois ans après dissociation du compte.
- Claude : Anthropic efface sous 30 jours les conversations supprimées, mais garde jusqu’à deux ans les échanges signalés, sept ans les scores de sécurité associés et cinq ans les données utilisées pour améliorer Claude.
Et pour les comptes professionnels ?
Au travail, on ne joue plus tout à fait avec les mêmes règles.
L’entreprise qui fournit le compte peut disposer de plus de contrôle sur les données, leur conservation ou les fonctions accessibles aux utilisateurs et utilisatrices.
Chez Claude for Work, par exemple, la personne qui administre le compte de l’organisation peut demander un export comprenant les conversations et les fichiers associés aux comptes de l’entreprise.
En contrepartie, ces offres protègent généralement davantage les échanges vis-à-vis du fournisseur lui-même.
OpenAI, Anthropic, Google ou Microsoft n’utilisent par exemple pas par défaut les données de leurs principales offres professionnelles pour entraîner leurs modèles.


 Reply With Quote
